
전신 동역학에 접촉 제약을 투영한 3 자유도 다리 시스템 실시간 MPPI 제어

Copyright© ICROS 2026
Abstract
This study proposes a whole-body Model Predictive Path Integral (MPPI) approach for unified motion planning and control of a 3-Degree-of-Freedom (DoF) leg system. High-potential dynamics in humanoid robots present significant control challenges, but Whole-Body Dynamics (WBD) enables physically consistent and dynamically rich motions suitable for real-world tasks without restrictive assumptions. Recent approaches combine WBD with Model Predictive Control (MPC) to achieve real-time planning and disturbance responsiveness, capable of generating more stable and agile motions. However, these methods face computational limitations in real-time applications. This study addresses these issues by utilizing MPPI, which leverages sampling-based optimization to generate stable and agile motions. Simulations verify that the proposed method effectively integrates full-body dynamics and supports real-time motion planning and control, with potential applications in dynamic locomotion tasks.
Keywords:
model predictive path integral, robot control, humanoids, whole body controllerI. 서론
휴머노이드 로봇은 전신이 수십개의 관절로 구성된 다자유도 시스템이며, 균형유지를 위한 동역학적 조건을 고려해야 하는 만큼 물리적으로 타당한 동작을 생성하기 위해서는 복잡하고 어려운 제어 문제를 실시간으로 해결할 수 있어야 한다.
이러한 문제를 해결하기 위해, 역진자와 같은 단순화한 모델 기반의 모델 예측 제어(MPC, Model Predictive Control)로 유효한 무게중심 경로를 계획하고[1,2], 이를 전신 동역학 기반 전신제어기[3]로 제어하는 방식이 흔히 사용되고 있다. 하지만, 이 경우 MPC를 활용하기 위해 모델을 선형화하는 과정에서 실제 시스템과의 모델 오차가 발생하며, 한정된 제약 조건 내에서만 동작을 생성할 수 있는 한계가 있다[4]. 이를 극복하고자 근래에는 전신 동역학 기반 MPC를 활용하여 다채로운 동작을 생성하는 연구들이 시도되고 있다.
그러나 기존의 MPC는 2차 계획법(QP, Quadratic Programming) 기반 계산을 사용하기 선형 제약 조건과 선형화된 모델에서만 최적화가 가능하기에, 비선형 동역학을 다루기 어렵다. 이런 한계를 해결하기 위해 DDP (Differential Dynamics Programming) [5]나 MPPI (Model Predictive Path Integral) [6,7] 과 같은 방법들이 연구되고 있다.
DDP는 비선형 시스템을 국소적으로 선형화하고 비용함수를 2차 근사하여 반복적으로 최적 제어 입력을 계산하는 기법이다. 이 과정에서 feedforward와 feedback gain을 함께 계산해 빠른 수렴과 안정성을 제공하지만, 비용함수가 미분 가능해야 한다는 단점이 존재한다. 그에 반해 MPPI는 샘플링 기반의 접근을 통해 최적 동작을 도출하며, 도함수를 사용하지 않고도 비선형 모델을 직접 활용할 수 있기에 구현이 간단하고 유연성이 높다. 또한, 병렬화가 가능해 계산 속도 측면에서도 이점을 가진다[6,7].
특히 전신 제어에서는 균형 유지를 위해 관절 토크와 지면 접촉력을 동시에 최적화해야 하는 어려움이 존재한다. 그래서 4족 보행 로봇 같은 부유기반 로봇에서는 이층 최적화 (bilevel optimization) 구조를 활용하여, 상위 계층에서 지면 접촉력을 먼저 계산한 뒤 하위 계층에서 관절 토크를 도출하는 방식이 제안되어왔다[8]. 그러나 이러한 방법은 이층 구조로 인해 두 번의 최적화를 수행해야 하므로 연산 부담이 커지게 된다.
본 논문에서는 이러한 한계를 극복하기 위해, MPPI로 접촉력을 별도의 최적화 변수로 두지 않고도 관절 토크를 직접 최적화할 수 있는 전신 제어 수식을 통해 계층적 구조가 아닌 단일 변수의 MPPI 기반 예측 제어 구조를 제안한다. 이를 통해 기존에는 어려웠던 전신동역학을 직접 다루는 MPPI 제어기를 개발하고 성공적으로 다양한 동작을 생성할 수 있음을 확인하였다. 제안된 방법은 시뮬레이션을 통해 검증하였으며, 2차원에서 움직이는 3자유도 로봇 다리가 지면 접촉 상태를 유지하며 몸통(base body)을 목표 위치로 이동 제어 가능함을 보였다.
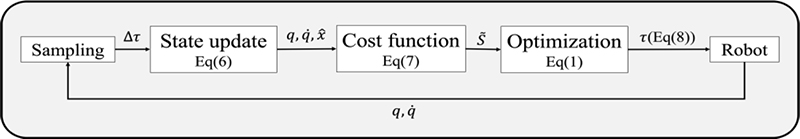
Overall framework.
II. 배경이론: MPPI
MPPI는 현재 상태(𝑥̂𝑖𝑛𝑖𝑡)를 입력으로 받아 제어 입력 시퀀스(𝛥𝛕)를 무작위로 샘플링하고, 각 샘플을 시스템 동역학 모델을 통해 미래 시간 지평선(𝑇) 동안 예측한다. 이 가중치는 비용이 낮은 경로일수록 더 크게 반영되어, 최적 제어 입력을 도출하는 데 기여한다. 갱신된 입력 시퀀스 중 첫 번째 입력만 실제 시스템에 적용되며, 나머지는 다음 시점 최적화의 초기값으로 활용된다. 자세한 알고리즘은 그림 2와 같다.
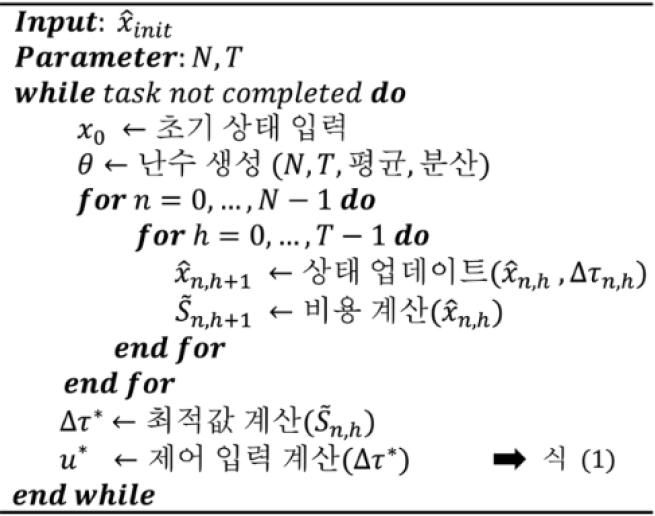
Model predictive path integral algorithm.
아래 그림 2 MPPI 알고리즘에서 사용되는 주요 변수들은 다음과 같다. N은 무작위로 생성되는 제어 입력 시퀀스 개수, 즉, 경로의 개수를 의미한다. T는 미래를 예측하는 지평선(horizon)의 길이를 나타내며, 각 경로는 이 길이만큼 전방으로 시뮬레이션 된다. 𝑢𝑛,ℎ는 n번째 경로의 h번째 제어 입력을 가리키며, 해당 입력에 따라 시스템 동역학을 통해 예측된 상태는 𝑥̂𝑛,ℎ로 표현된다. 또한, 각 경로의 성능을 평가하기 위해 누적 비용이 계산되며, 이는 S̃𝑛,ℎ로 표기된다.
이때, 제어 입력에 사용되는 확률적 가중합은 iterative update law에 따라 아래와 같다.
| (1) |
여기서 𝜆는 탐색과 최적화 간의 트레이드 오프를 조절하는 온도 매개변수로, 자세한 식의 도출과정은 [6,7]에 자세히 제시되어 있다.
MPPI는 이와 같은 갱신 과정을 반복 수행함으로써 샘플 기반의 실시간 최적 제어를 가능하게 한다. 특히, 시스템 모델에서 별도의 제약을 두지 않고 비용 함수에 대한 gradient 계산도 필요하지 않다는 점에서 본 연구에서와 같이 전신 동역학 제어 문제에 매우 적합하다.
III. 제안 방법
전신 제어 문제는 전신 동역학 식에서 접촉력과 토크를 모두 결정되야 하는 문제이다. 하지만, 두 변수는 본질적으로 서로 연관되어 있기 때문에 두 변수를 동시에 다루는 것은 계산적으로 매우 복잡하다. 특히, 샘플링 기반 기법에서는 접촉력과 토크가 독립적으로 샘플링 되어 이들의 연관관계를 충분히 반영하기 어렵다. 그 결과 유효한 샘플의 비율이 급격히 감소하고, 효율적인 탐색을 위해 방대한 양의 샘플링이 요구된다.
이러한 이유로 기존 연구 [9]에서는 주로 상∙하위 계층으로 분리하여, 상위 계층에서 접촉력을 먼저 산출한 뒤 이를 바탕으로 하위 계층에서 토크를 최적화하는 방식을 사용하였다. 그러나 이는 원래 하나의 연산으로 해결할 수 있는 문제를 두 단계로 분리하는 방식이므로, 계산 복잡도가 증가하고 실시간 제어 적용이 어렵다.
따라서 본 연구에서는 이러한 문제를 해결하기 위해 접촉력 최적화를 생략하고, 접촉 조건을 전신 동역학 식에 투영하여 토크만을 직접 최적화할 수 있는 구조를 제안한다. 제안하는 제어기는 그림 1과 같이 전신 동역학 모델과 MPPI 기반 최적제어기를 통합한 구조로 설계되었다. 구체적으로, 샘플링을 통해 다양한 입력 후보를 생성하고, 이를 전신 동역학에 기반한 상태 업데이트와 비용 함수 계산을 거쳐 최적화 단계로 전달한다. 이후 산출된 최적 토크는 로봇에 직접 적용되며, 다시 로봇의 관절 정보가 피드백되어 제어 루프를 형성한다.
제안된 제어기의 접촉 조건이 반영된 전신 동역학식은 접촉조건 투영 전신동역학 식 [8]을 바탕으로 하고 있다. 로봇의 전신 동역학은 접촉력(𝑓𝑐)를 포함하여 다음과 같이 표현될 수 있다.
| (2) |
여기서 𝜏는 관절 토크, M은 관성 행렬, 𝑞는 관절각도 벡터 h는 코리올리/원심력 벡터, g는 중력 벡터, 𝐽𝑐은 접촉 지점에 대한 자코비안 행렬을 의미한다.
로봇이 지면과 맞닿는 접촉 지점의 위치를 𝑥𝑐라 하면, 접촉점의 운동학적 관계는 다음과 같이 표현된다.
| (3) |
여기서 𝑥̇𝑐, 𝑥̈𝑐는 로봇이 지면과 맞닿은 접촉점의 속도와 가속도를 의미한다. 이때, 로봇이 정적인 접촉 상태를 유지하기 위해서는 접촉점이 지면에 고정되어 미끄러지거나 떨어지지 않아야하므로
| (4) |
이 성립한다. 이 조건을 이용하면, 정지 접촉 상태에서의 접촉점에서의 반력 𝑓𝑐는 전신 동역학식으로부터 𝐽𝑐𝑞̈ + 𝐽̇𝑐𝑞̇ = 0을 대입하여 다음과 같이 유도된다.
| (5) |
| (5-1) |
| (5-2) |
| (5-3) |
| (5-4) |
이때 φc, 𝑝𝑐, μc, 는 각각 관성, 코리올리/원심력, 중력, 그리고 자코비안 행렬이 접촉 공간으로 투영된 값이다. 이렇게 유도된 식 (5)을 식 (2)에 대입하면, 접촉력이 제거되고 접촉 제약이 반영된 전신 동역학식은 다음과 같이 표현된다.
| (6) |
식 (6)은 정적 접촉 조건이 투영된 전신 동역학식으로, 접촉력을 별도의 최적화 변수로 두지 않고도 접촉 제약이 내재된 토크 해를 직접 계산할 수 있음을 의미한다.
특히 식 (4)를 상태 업데이트 식으로 직접 사용함으로써 전신 동역학에 접촉 제약을 자연스럽게 포함할 수 있고, 그 결과 최적화 변수의 수를 줄여 계산 효율성을 크게 향상시킬 수 있다. 이때 별도의 접촉력 변수를 도입하지 않아도 제어 토크가 접촉 조건을 내재적으로 반영하게 되므로, 물리적으로 실현 불가능한 입력이 사전에 배제된다. 이는 특히 접촉이 빈번하게 발생하는 다리 시스템에서 동작 계획의 안정성을 높이는 핵심적인 요소가 된다. 더 나아가 MPPI와 결합했을 때는 탐색 공간이 불필요하게 확장되지 않으므로, 샘플 기반 최적화 과정의 수렴 속도를 가속화하고 실시간 제어 성능을 개선하는 효과를 얻을 수 있다.
IV. 실험 결과
실험은 Intel I7-12700F, RAM 32GB의 사양을 가진 PC로 Mujoco Simulator에서 C++로 구현하여 진행하였다. 로봇은 3자유도의 다리 시스템으로, 제어 차원과의 일치를 위해 움직임을 X, Z 평면으로 제한한 2차원 환경에서 검증하였다. 여기서 X축은 로봇 기준 전후 방향, Z축은 상하 방향을 나타낸다.
본 연구에서는 토크의 변화량을 정규 분포로 샘플링하여 업데이트 주기 dt 0.005 s, 샘플 개수 100, 분산 0.05로 총 0.025 s를 미래 예측 시간으로 설정하고 시뮬레이션을 진행하였다. 사용한 비용함수는 아래 𝐶𝑠와 같다.
| (7) |
𝐶𝑔𝑜𝑎𝑙는 작업에 있어서 가장 큰 가중치를 둔 비용 함수로, 예측된 로봇 상태의 위치와 목표 위치 간의 차이를 기반으로 계산된다. 또한, 동적 안정성을 고려하기 위하여 ZMP (Zero Moment Point) 조건을 추가적으로 반영하였다. ZMP는 로봇이 넘어지지 않고 균형을 유지하기 위한 대표적인 안정성 지표로, 그 값이 지지 다각형(support polygon) 내부에 존재해야 로봇이 안정적으로 동작할 수 있다. 반대로, ZMP가 지지 영역을 벗어나는 경우에는 균형 유지가 어렵기 때문에 해당 상황을 s=1로 정의하여 큰 비용을 부여함으로써 안정성을 보장하도록 설계하였다. 비용을 이루는 각 항들은 같은 스케일 값을 맞출 수 있도록 𝐶𝑔𝑜𝑎𝑙앞에 Q를 곱해주었다.
앞서 정의한 비용 함수를 통해 식 (1)에서 산출된 최적화 결과 Δ𝜏∗는 최종적으로 토크 형태로 로봇에 적용된다. 이때, 로봇에 적용되는 토크는 아래와 같이 구성된다.
| (8) |
여기서 𝜏∗ = 𝜏𝑝𝑟𝑒𝑣 + ∆𝜏∗는 최적화 과정을 통해 갱신된 토크 항이며, 𝑞𝑑𝑒𝑠는 예측된 최적 상태를 반영하여 업데이트된 목표 위치이다. 따라서 제어기는 최적화된 토크와 PD 제어 항을 결합함으로써, 로봇이 목표 상태를 추종하면서도 안정적으로 현재 상태를 피드백 받아 동작할 수 있도록 설계하였다.
작업으로는 발바닥 지면접촉을 유지하며 몸통의 위치와 방위가 잘 제어되는지 보기 위해, 몸통이 실제로 도달 가능한 지점과 갈 수 없는 지점을 목표지점으로 주었다.
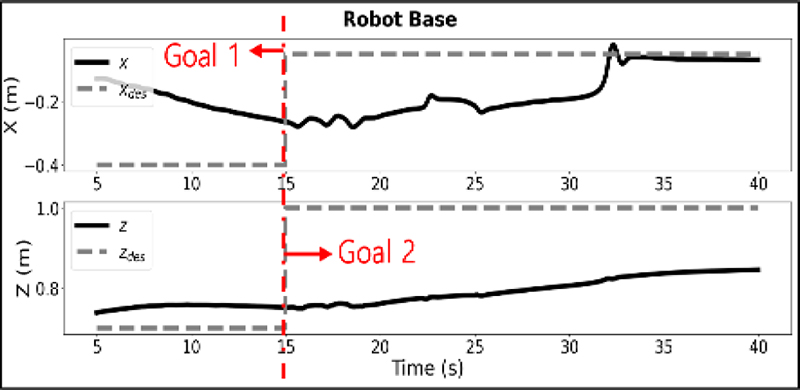
목표 지점이 접촉을 유지한 채 도달 가능한 공간에 있는 경우, 그림 4의 결과와 같이 접촉을 잘 유지하며 X와 Y 모두 수렴하는 모습을 보였다. 또한, 그림 5와 같이 접촉을 유지할 수 없는 지점을 목표 지점으로 주었을 시에도 접촉을 유지하며 최대한 도달하려 하는 모습을 확인할 수 있었다. 특히 목표 지점이 로봇의 최대 도달 범위를 넘어서는 경우에도, 점프와 같은 불가능한 동작 대신 관절의 자유도를 최대한 활용하여 최대 가동 범위를 활용한 자세로 수렴하는 모습을 확인할 수 있었다.
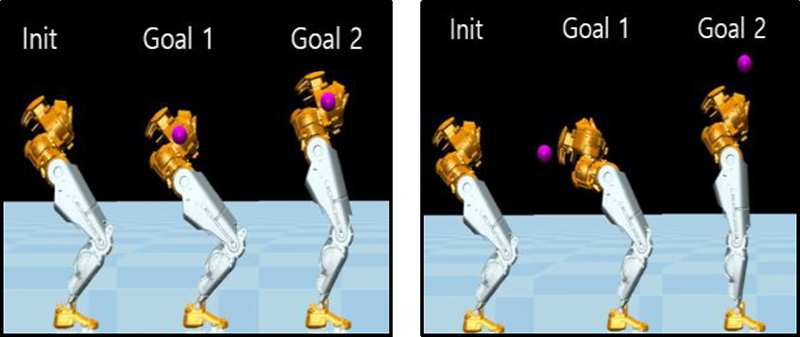
Robot with reachable (left) and unreachable (right) targets.
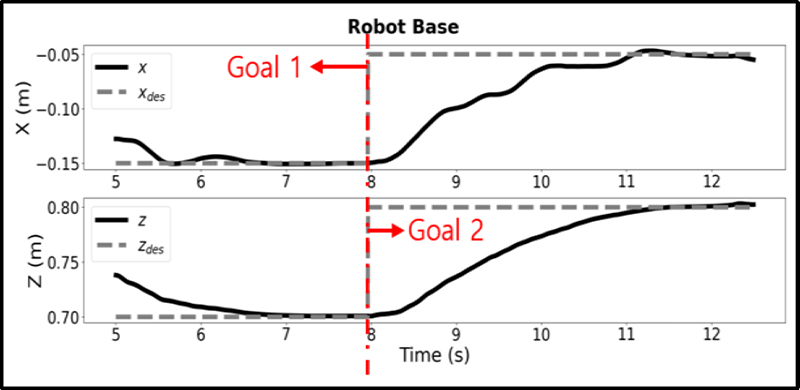
X and Z by reachable goal point.
X and Z by Unreachable Goal Point.
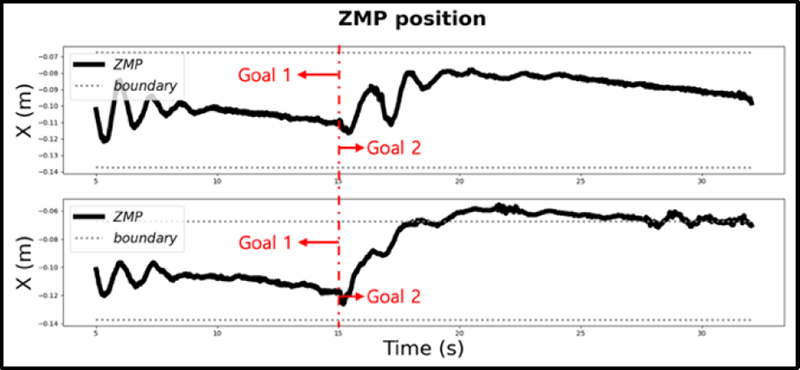
이는 비용 함수에서 목표 추종 항의 가중치가 가장 크게 설정되었음에도 불구하고, 접촉 제약이 반영된 전신 동역학 모델을 통해 물리적으로 실현 가능한 궤적만을 생성하고 안정성을 한번 더 고려하기 위해 포함한 ZMP항의 결과라 할 수 있다. ZMP항이 미치는 영향은 그림 6과 같이 ZMP항이 있을 때(그림 6의 위 그래프)와 포함되어 있지 않을 때(그림 6의 아래 그래프)를 통해 확인할 수 있다. ZMP에 대한 비용 함수를 고려했을 때(그림 6의 위 그래프)는 ZMP가 지지 영역 경계에 근접했을 때 패널티 항의 작동으로 경계 밖으로 벗어나는 현상이 억제되는 모습이 나타난다. 반대로, ZMP 범위는 실제 발의 크기보다 보수적으로 잡았고 접촉 제약이 반영된 전신 동역학을 사용하였기에 넘어지진 않았지만, ZMP 항이 비용함수에 있지 않을 때(그림 6의 아래 그래프)에는 범위를 벗어나는 모습을 확인할 수 있다.
ZMP position variation with and without ZMP penalty term.
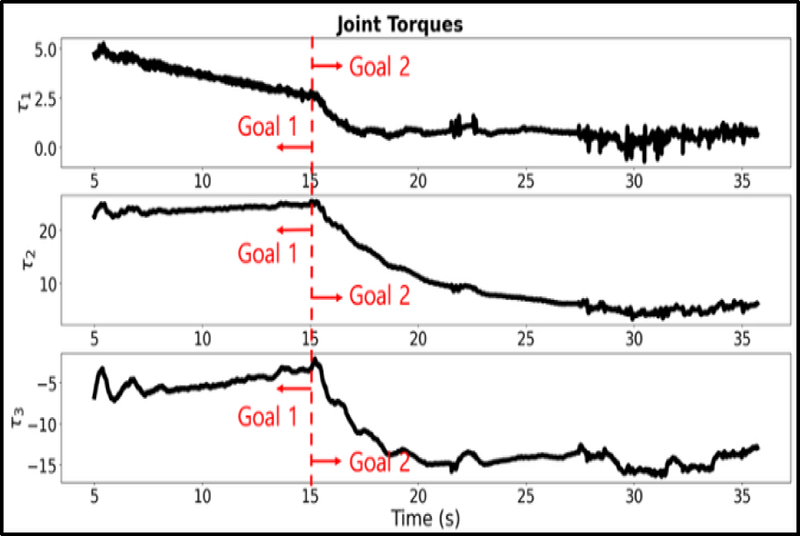
추가적으로, 제안한 제어기의 목표지점 변화에 따른 각 관절 토크 응답을 확인해보았다. 그림 7을 보면, 목표지점이 step형식으로 주어짐에도 불구하고 MPPI를 통해 얻은 제어입력 토크가 연속적으로 변화하며 토크 한계치(-100 ~ 100)를 벗어나지 않는걸 확인할 수 있었다. 이는 실제로봇에도 적용이 가능한 수치로 MPPI 제어기가 변동 입력에 대해서도 안정적으로 토크를 생성할 수 있음을 보여준다.
Joint torque responses to step input.
모든 작업에 대한 연산시간은 평균 4.73 ms로 200 Hz 실시간 제어가 가능했다. 특히, 연산시 MPPI의 장점인 병렬처리를 적용하지 않았음에도 빠른 연산 성능을 보였다. 따라서 향후 병렬 연산을 적용할 경우, 보다 높은 자유도의 이족로봇에서도 실시간 전신 MPC가 가능할 것으로 기대된다.
V. 결론
본 연구에서는 전신 MPPI의 초기 적용 사례로서, 3자유도 다리 시스템을 대상으로 실시간 제어 성능을 검증하였다. 특히, 접촉력이 제거된 형태의 동역학 식을 상태 업데이트 식으로 사용함으로써, MPPI에서 샘플링되는 샘플 변수를 줄여 계산 효율성을 높일 뿐 아니라, 샘플링되는 제어 토크가 접촉 조건을 위배하지 않도록 자연스럽게 제약했다. 이 구성은 [9]의 접촉-일관 전신 동역학을 MPPI의 예측 모델로 채택하고, 접촉력 𝑓𝑐가 소거된 식 (6)을 사용함으로써 전신 MPPI에서 관절 토크 중심의 샘플링이 가능하도록 하였다.
그 결과, 별도의 경로계획 없이도 접촉을 유지하며 목표 지점으로 수렴하는 동작을 생성하였고, 도달 불가능한 목표 지점이 주어졌을 때에도 접촉을 유지한 채 근접하려는 모습을 보였다. 이는 선형화된 모델이 아닌 전신 동역학을 사용하면서도 변수를 축소를 통해 효율적인 탐색을 보장하여 빠른 수렴을 달성한 결과이다.
본 연구는 초기 적용 사례로 2D 평면 상의 3자유도 다리 시스템에 국한되었으나, 제안한 MPPI구조는 전신 동역학 모델을 직접 사용할 수 있다는 점에서 3차원 보행이나 다족 로봇 시스템으로의 확장이 용이하다. 현재는 병렬 처리가 적용되어 있지 않아 연산시간 제약으로 고자유도 시스템에의 확장은 이루어지지 않았으나, 향후 연구에서는 병렬화 기법을 도입하여 연산 효율을 개선하고, 접촉 전환을 고려한 제어기로 확장함으로써 3차원 휴머노이드 로봇 제어에도 적용할 수 있을 것으로 기대된다. 또한, 본 연구에서는 정적 접촉 조건을 가정하여 접촉이 유지되는 상황만을 다루었으나, 향후에는 접촉 전환 플래너와의 통합을 통해 변환이 포함된 동적인 보행 제어 문제로 확장할 예정이다.
Acknowledgments
이 논문은 제40회 제어로봇시스템학회 학술대회(ICROS2025)에 초안[10]이 발표되었음.
본 연구는 과학기술정보통신부의 재원으로 한국연구재단(NRF)의 지원(RS-2024-00339632)을 받아 수행되었음.
REFERENCES
-
P.-B. Wieber, “Trajectory free linear model predictive control for stable walking in the presence of strong perturbations,” Proceedings of the 6th IEEE-RAS International Conference on Humanoid Robots (Humanoids), pp. 137–142, 2006.
[https://doi.org/10.1109/ICHR.2006.321375]

- J. D. Lee and H. M. Jo, “Stable walking pattern generation for humanoid robot using learning-based model predictive control,” Proc. of 2025 40th ICROS Annual Conference (ICROS 2025), pp. 205-206, 2025.
-
Z. Zhu, W. Zhu, G. Zhang, T. Chen, Y. Li, X. Rong, R. Song, D. Qin, Q. Hua, and S. Ma, “Design and control of BRAVER: a bipedal robot actuated via proprioceptive electric motors,” Autonomous Robots, vol. 47, no. 8, pp. 1229–1243, 2023
[https://doi.org/10.1007/s10514-023-10117-5]
- Z. Gu, J. Li, W. Shen, W. Yu, Z. Xie, S. McCrory, X. Cheng, et. al., “Humanoid locomotion and manipulation: current progress and challenges in control, planning, and learning,” arXiv preprint arXiv:2501.02116, , 2025.
-
I. Chatzinikolaidis and Z. Li, “Trajectory optimization of contact-rich motions using implicit differential dynamic programming,” IEEE Robotics and Automation Letters, vol. 6, no. 2, pp. 2626–2633, 2021.
[https://doi.org/10.1109/LRA.2021.3061341]
- G. Williams, A. Aldrich, and E. Theodorou, “Model predictive path integral control using covariance variable importance sampling,” arXiv preprint arXiv:1509.01149, , 2015.
-
G. Williams, A. Aldrich, and E. A. Theodorou, “Model predictive path integral control: From theory to parallel computation,” Journal of Guidance, Control, and Dynamics, vol. 40, no. 2, pp. 344–357, 2017.
[https://doi.org/10.2514/1.G001921]
-
J. Hwangbo, J. Lee, and M. Hutter, “Per-contact iteration method for solving contact dynamics,” IEEE Robotics and Automation Letters, vol. 3, no. 2, pp. 895–902, 2018.
[https://doi.org/10.1109/LRA.2018.2792536]
- J. Park and O. Khatib, “Contact consistent control framework for humanoid robots,” Proceedings of the 2006 IEEE International Conference on Robotics and Automation (ICRA 2006), IEEE, 2006.
- Y. Seo, M. Lim, and Y. Lee, “Whole Body MPPI for Real-time Control of a 3-DoFs Leg system,” Proc. of 2025 40th ICROS Annual Conference (ICROS 2025), pp. 193-194, 2025.
2024년 동국대학교 기계로봇에너지공학과(공학사). 2024~현재 고려대학교 대학원 전기전자공학과 석사과정 재학 중. 관심분야는 보행 제어, 최적 제어.
1985년 고려대학교 전기공학과(공학사). 1987년 고려대학교 전기공학과(공학석사). 1990년 미국 Rutgers University 전기공학과(공학박사). 삼성종합 기술원 선임연구원, 국립창원대학교 제어계측공학과 교수를 역임하였으며, 1996년~현재 고려대학교 전기전가공학부 교수. 관심분야는 최적 및 강인 제어, 영상 기반 모션 제어, 자율 이동 로봇.
2008년 서울대학교 조선해양공학과(공학사). 2010년 서울대학교 조선해양공학과(공학석사). 2017년 서울대학교 융합과학기술대학원 지능형시스템(공학박사). 2018년~2020년 Istituto Italiano di Tecnologia 박사후 연구원, 2020년~현재 한국과학기술연구원 휴머노이드연구단 책임연구원. 관심분야는 휴머노이드 로봇 제어.